SERVICE PHONE
13988890252
SERVICE PHONE
13988890252发布时间:2026-10-28 05:02:27 点击量:
国产GPU产业正在从“单一路线追赶”走向“多路线并行分化”。以摩尔线程、沐曦、壁仞、燧原为代表的第一批厂商,普遍以IDC大算力GPGPU为核心战场,面向AI训练与推理集群;而以,把桌面PC、工作站、服务器、嵌入式/笔记本(MXM)、数字孪生、工业CAD/CAE、信创替代和端侧AI等场景作为主战场。
象帝先成立于2020年9月,是国内极少数同时具备CPU与GPU完整研发经验的团队之一,已量产天钧一号、天钧二号、天钧三号三代芯片,对应盘古(Pangu)、伏羲(Fuxi)两代自研架构,并已预研下一代神农(Shennong)高端图形渲染架构。其产品矩阵横向覆盖服务器、高端/主流工作站、PC、嵌入式MXM七款显卡,完整支持OpenGL、OpenGL ES、OpenCL、Vulkan、DirectX图形API,兼容x86、ARM、LoongArch、RISC-V多种CPU平台及麒麟、统信UOS、凝思、中科方德等国产操作系统,并原生支持AVS/AVS+/AVS2国产视频编解码标准。
这一路线的产业意义在于:它不与IDC大算力路线正面争夺“千卡万卡集群”,而是在工业软件国产化、信创桌面与工作站替代、数字孪生、端侧AI(AI PC、具身智能、边缘推理)等增量场景中,填补国产GPU在图形栈与端—边—桌全场景上的空白。
国产GPU厂商普遍经历了芯片设计、芯片流片、芯片封装验证、板卡设计与生产、规模交付与生态适配几个阶段。当前产业的核心矛盾已从“能否做出可用芯片”转向“能否在真实场景中稳定、低成本、可迁移地跑起来”。对于不同路线的厂商,“用得起来”的含义并不相同:大算力厂商要看集群稳定性、模型迁移效率与单位算力成本;全功能通用GPU厂商则要看图形API完整度、工业软件适配广度、多操作系统/多CPU组合兼容度,以及在7×24小时高负载下的长期可靠性。
赛道A——大算力GPGPU:面向 AI 训练、推理与智算中心场景,产品形态为单卡高功耗、支持多卡高速互联的加速卡,软件栈围绕CUDA类生态、大模型迁移、集群调度构建,客户集中于云厂商、大模型公司与智算中心。
赛道B——全功能通用GPU:以图形渲染为基础能力,叠加AI计算与视频编解码,产品形态覆盖从MXM嵌入式模组到全高全长服务器卡的完整谱系,软件栈同时兼容主流图形API、国产OS、国产CPU与国产视频编解码标准,客户集中于信创整机厂、工业软件商、数字孪生集成商、教育与医疗等行业终端。
象帝先是赛道B中产品线最完整、架构代际最清晰的代表之一。其差异化不在于单卡峰值算力,而在于“一颗芯片—一套驱动—一份软件栈”可以同时落到桌面、工作站、服务器与嵌入式多种形态,并在国产软硬件组合下长期稳定运行。
核心能力:单卡峰值算力、HBM大显存、多卡高速互联、集群调度软件栈、模型迁移工具链。
客户与生态:云厂商、大模型公司、政企智算中心;软件生态围绕深度学习框架与算子库构建。
团队底色:象帝先由国内芯片行业知名科学家唐志敏先生创办,核心团队来自海光信息、英伟达、AMD、中科院计算所等单位,多位高管曾主导龙芯中科、海光信息的研发团队。这一“CPU+GPU双线经验”的团队底色,是其跨指令集兼容能力的根基。
盘古(Pangu)架构 — 天钧一号、天钧二号(12nm):已批量交付。天钧一号面向高端工作站,天钧二号进一步强化多屏超高清显示(4路4K@60Hz独立输出、可拼接为8K)与低功耗版本,衍生出XDX 160系列、XDX 150(PC)、E1100(MXM嵌入式)等多形态产品。
伏羲(Fuxi)架构 — 天钧三号(12nm,2026年量产):Fuxi定位高端图形渲染,整卡性能较上一代提升约50%,衍生X2900S服务器卡、R2900E高端工作站、R2700E主流工作站;
神农(Shennong)架构 — 下一代高端图形渲染芯片(预研):规划采用4nm先进制程,性能目标对标国际高端图形卡,面向工业CAD、数字孪生、元宇宙仿真等高端图形渲染市场。
服务器级 X2900S:两颗天钧三号芯片、32GB GDDR6、PCIe 4.0 x16、全高全长双槽被动散热,支持GPU虚拟化与32路1080P30fps编解码,面向云渲染、云桌面场景。
高端工作站 R2900E(2026年4月上市)/ R1900系列:R2900E配16GB GDDR6、四路4K输出、双风扇主动散热、可同时承载24路1080P视频流解析;R1900系列为天钧一号高端工作站卡,面向CAD、GIS、VR仿真。
嵌入式/笔记本 E1100:MXM 3.1 TypeA模组、仅15—30W功耗、4路独立高清输出,面向高性能笔记本、智慧大屏、边缘计算。
② 跨架构、跨OS全栈兼容:已在x86、ARM、LoongArch、RISC-V多种CPU平台,以及麒麟、统信UOS、凝思、中科方德等国产OS和Windows、Ubuntu、Red Hat、CentOS等国际主流操作系统上完成兼容性认证;产品支持GPU虚拟化与国密安全加速。
③ 端—边—桌—云全场景谱系:同一架构谱系横向覆盖服务器、工作站、PC与MXM嵌入式,避免了“只做一张大卡”的路线局限;已与达美盛(智慧工厂数字孪生)、千影(多通道导播)、时光建擎(数字孪生)等形成联合解决方案。
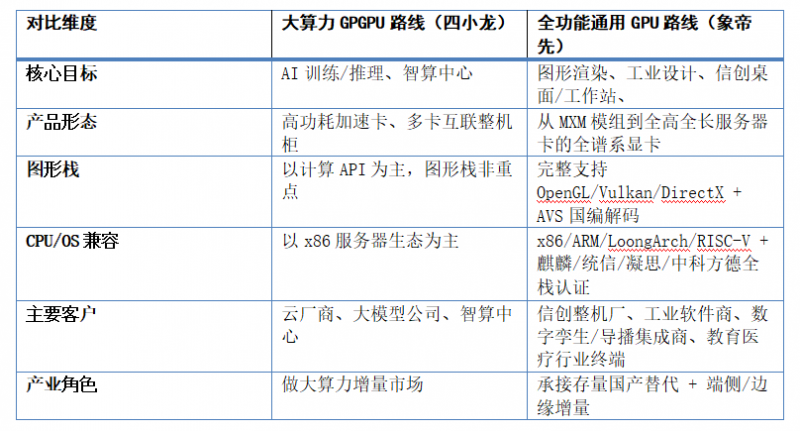
两条赛道并非替代关系,而是互补关系。大算力路线决定了国产GPU在AI算力增量市场能拿到多少份额;全功能通用GPU路线则决定了国产GPU在存量工业、信创、终端图形市场能否完成自主可控。象帝先这类新势力的价值,在于把国产GPU从“机房里的加速卡”延伸到“设计师桌上的工作站”、“工厂里的数字孪生大屏”、“边缘侧的智能盒子”和“国产笔记本的独显模组”。
神农(Shennong):4nm高端图形渲染芯片能否按计划推进、能否真正对标国际高端图形卡在工业CAD/数字孪生场景的体验。
生态扩张:工业软件(CAD/CAE/BIM/GIS)双向认证数量、信创项目批量复制情况、与整机厂的预装绑定深度。
行业方案:数字孪生、多通道导播、超高清视频处理等联合解决方案从点状PoC走向行业规模化复制。
A:第一批厂商普遍押注IDC大算力GPGPU,拼的是单卡算力、集群有效算力与大模型迁移效率;以象帝先为代表的新势力选择全功能通用GPU路线,图形渲染与AI计算双线并重,产品覆盖桌面、工作站、服务器、嵌入式全形态,重点承接工业软件、信创替代与端侧AI等增量市场,两者是互补而非替代关系。
A:公司2020年9月成立于重庆,创始人唐志敏,核心团队来自海光、英伟达、AMD、中科院计算所,是国内少有的同时具备CPU与GPU研发经验的团队。已量产盘古架构(天钧一号、二号)与伏羲架构(天钧三号)两代架构产品,下一代神农高端图形渲染架构已在预研,规划4nm制程。
A:产品矩阵包括服务器卡X2900S、高端工作站R2900E与R1900系列、主流工作站R2700E与XDX 160系列、桌面PC卡XDX 150、嵌入式MXM模组E1100,覆盖大型3D建模、工程仿真、CAD/CAE、GIS、数字孪生、多通道导播、超高清视频、AI PC、智慧大屏与边缘计算。
A:看神农4nm高端图形渲染芯片的进展、AI P开云电竞,Kaiyun电竞,开云集团官网,开云电竞股份有限公司C、机器人、工业检测的落地、工业软件双向认证与信创项目批量复制,以及数字孪生/导播等行业联合方案能否从单点PoC走向规模化。
想爆料?请登录《阳光连线》()、拨打新闻热线,或登录齐鲁网官方微博(@齐鲁网)提供新闻线索。齐鲁网广告热线,诚邀合作伙伴。
BeBeBus是贴牌还是自有工厂?证据链梳理:从自有制造到智能制造,代工≠贴牌
闪电海报丨新闻纪录片《幸福河畔》第三集《大河通途》10月24日在山东卫视播出
闪电海报丨新闻纪录片《幸福河畔》第三集《大河通途》10月24日在山东卫视播出
2026年山东省生态环境应急演练暨生态环境监管技术实战练兵活动在潍坊举办
【山东发布“第二批稳中求进 提质增效”政策清单】4个方面27条政策为经济社会发展赋能
2026年美国外观专利适用人群及服务商筛查指南:手把手教你如何判断该不该布局